執行這個策略
複製提示詞,讓 AI 依照上方證據的資料、條件與風險檢查重跑一次。
告訴你的AI:
幫我設定 FinLab,用機器學習對台股做橫截面排序產生選股訊號並回測,請讀:https://finlab.finance/setup?relatedUrl=/blog/machine-learning-predict-stock-price
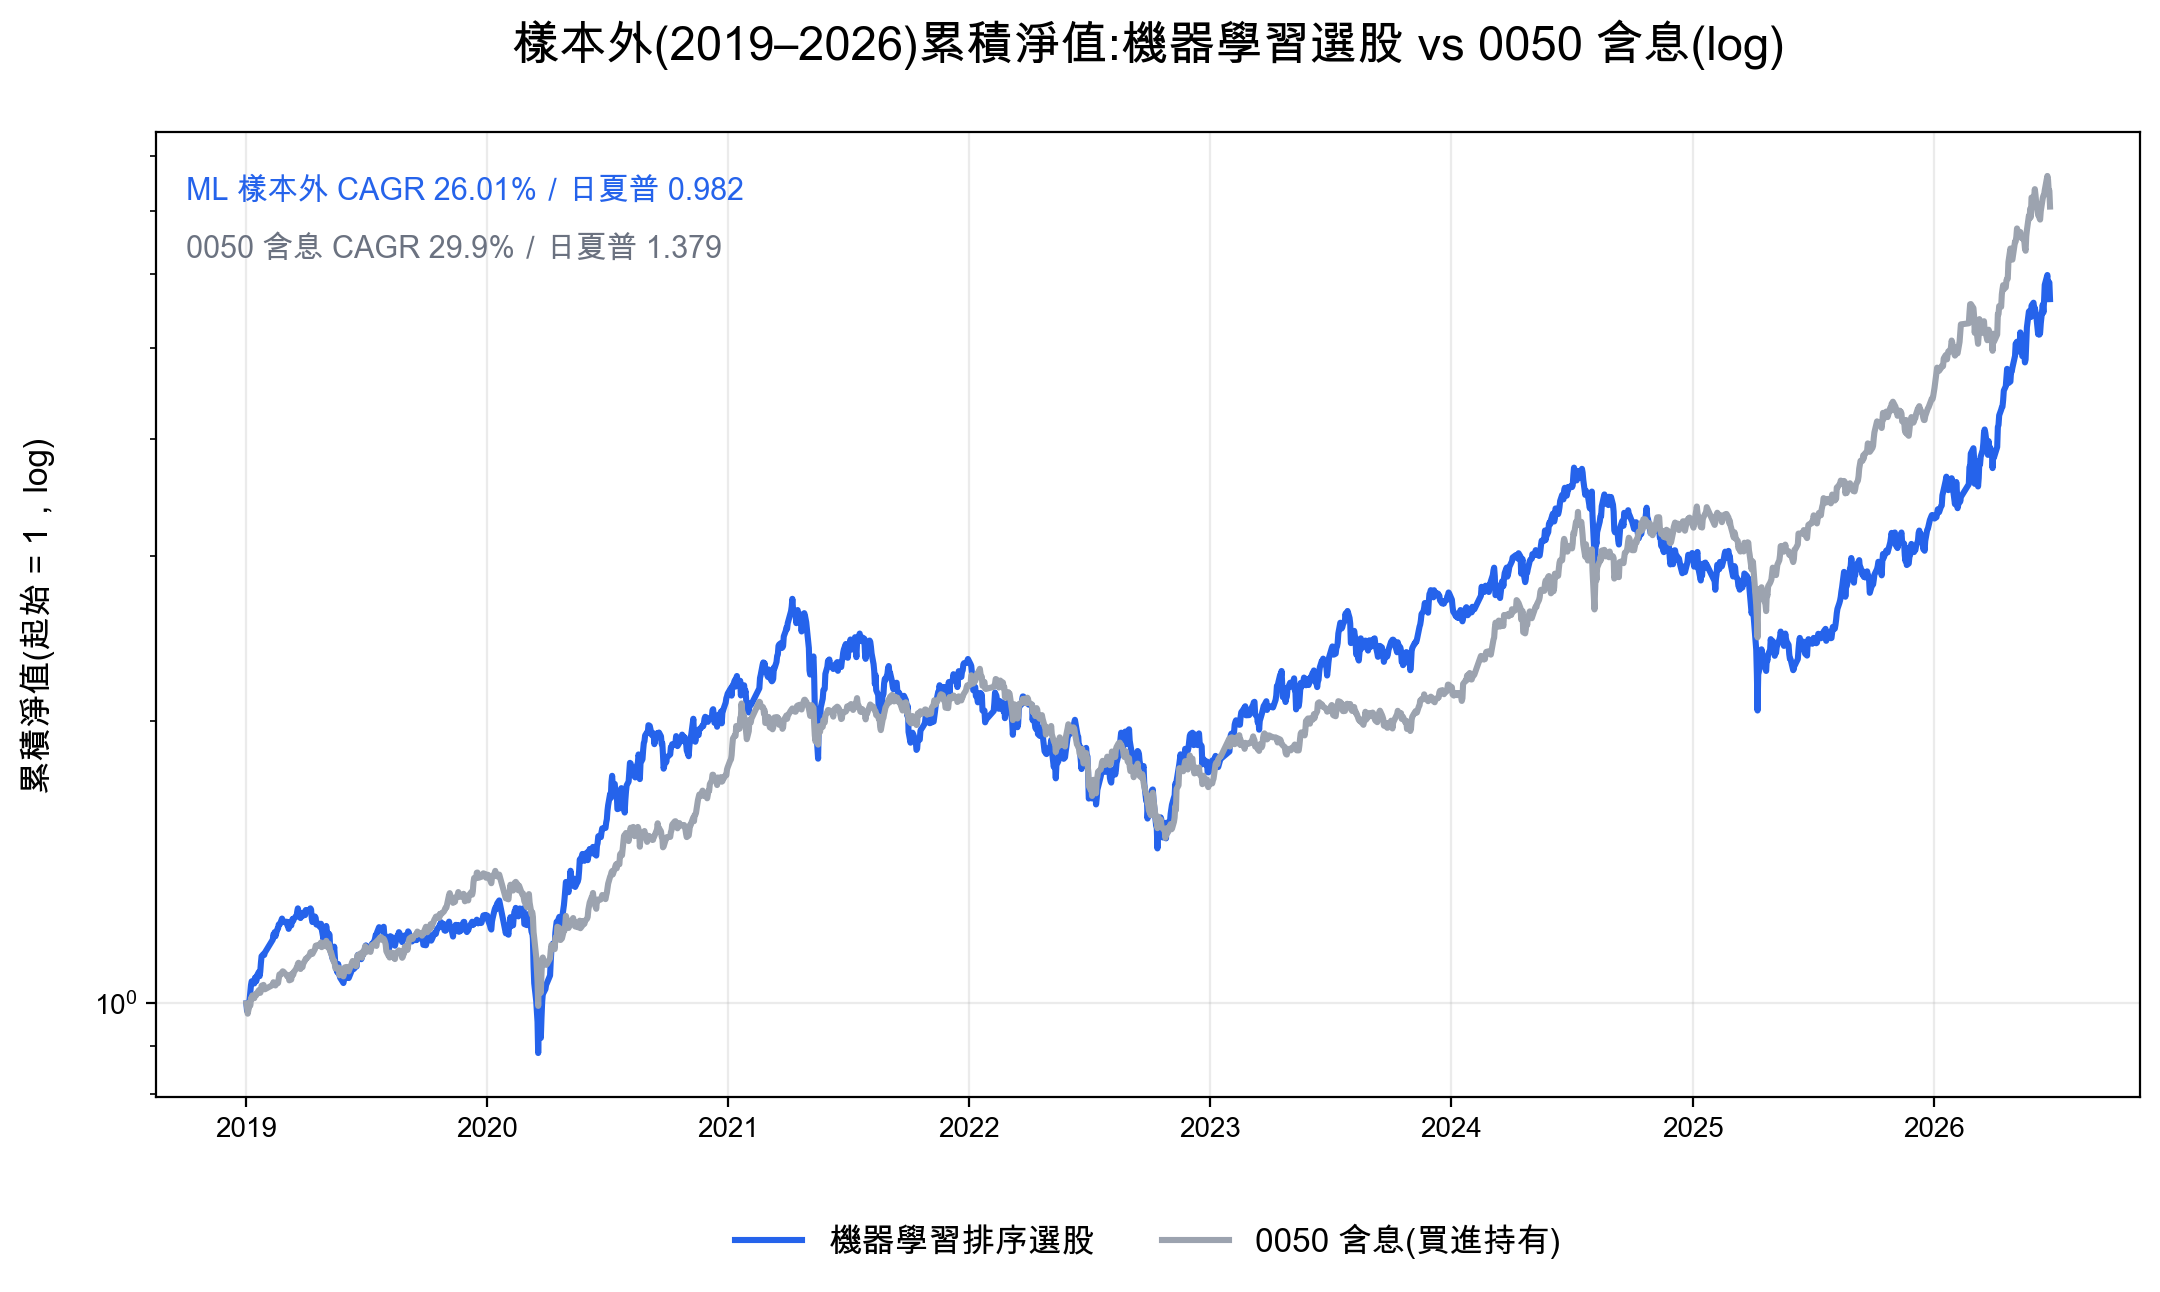
用機器學習直接預測股價的「價位」幾乎注定失真;但把同一套模型拿來對全市場股票做「橫截面排序」、產生選股訊號,在台股 2019 至 2026 的樣本外是有效的。 模型分數最高的一組(第 10 組)次月相對中位數的超額報酬達 2.64%,由低到高大致單調遞增,樣本外 Rank IC 0.027、且 CPCV 15 折全為正。但把訊號做成每月買進前 30 名的策略後,樣本外年化報酬 26.0%、日夏普 0.98、最大回撤 -45.8%,仍輸給同期含息 0050 的年化 29.9%、日夏普 1.38、最大回撤 -34.0%。訊號真的有預測力,做成實際策略卻沒打敗大盤,這兩件事可以同時成立,本文用真實回測把它拆給你看。本文因此以反面教材呈現:訊號有效不等於策略贏過大盤,讀者應把它當成「怎麼檢驗一個機器學習訊號」的流程示範,而不是可直接照抄的策略。
關鍵數字表(2019 至 2026 樣本外)
| 指標 | 機器學習排序選股 | 含息 0050 |
|---|---|---|
| 年化報酬(CAGR) | 26.0% | 29.9% |
| 日夏普比率 | 0.98 | 1.38 |
| 月夏普比率 | 0.87 | 1.25 |
| 最大回撤(MDD) | -45.8% | -34.0% |
| 累積報酬 | 463.6% | 607.4% |
| 樣本外 Rank IC | 0.027 | 不適用 |
| 平均月周轉率 | 164% | 約 0% |
回測區間 2019-01 至 2026-06,模型只用 2018 年底以前的資料訓練,2019 年起為完全未見過的樣本外資料。交易成本由 finlab
sim()內扣(手續費 0.1425%、證交稅 0.3%)。基準為含息 0050(etl:adj_close還原價買進持有),對齊同一視窗。
為什麼「預測股價」這條路走不通
把股價當成一條時間序列、要模型輸出「明天收盤價是多少」,看起來很自然,實務上卻有兩個致命問題。
第一,股價不是穩定(stationary)的序列。它的平均值與波動會隨時間漂移,今天訓練好的數值關係,到了下一個多空循環就失效。模型為了在訓練集把誤差壓低,往往退化成「用昨天的價格猜今天」,結果就是大家熟知的預測延遲:預測曲線永遠比真實價格慢半拍,看起來很貼近,拿去交易卻一文不值,因為等訊號出現,行情早就走完了。
第二,就算誤差很小,也不代表能賺錢。預測值與真實值的均方誤差(MSE)衡量的是「猜得準不準」,但交易要的是「方向對不對、相對強弱排得對不對」。一個 MSE 很低的模型,可能在每個轉折點都站錯邊。Gu, Kelly & Xiu (2020) 在橫跨數十年的美股大型實證裡就指出,機器學習對資產報酬的價值,主要來自橫截面的相對排序,而非對單一資產價位的點預測。
正確用法:用模型產生「排序訊號」
換個問法,問題就變得可解:不要問「這檔股票會漲到多少」,改問「這檔股票下個月會不會贏過市場上一半的股票」。 這是一個橫截面排序問題,輸出是一個相對分數,不是絕對價位。
落到 finlab 的實作上,這對應到 finlab.ml.label.excess_over_median:它把每一檔股票「次月相對全市場中位數的超額報酬」當成學習標籤。模型學的是「誰會贏過中位數」這個排序關係,而不是「股價會到幾元」。每個月底,模型對全市場每一檔流動性足夠的股票打一個分數,我們做多分數最高的前 30 名,下個月底再重排一次。
這段就是核心程式碼,複製即可在 finlab 跑
下面這段把流程拆成「組特徵 → 設標籤 → 訓練 → 每月選前 30 名 → 回測」五步,你可以直接貼進 finlab 環境執行。完整版本(含 CPCV 穩健性檢查與繪圖)在文末提供下載。
顯示程式碼
import finlab
import pandas as pd
from finlab import data
import finlab.ml.feature as mlf
import finlab.ml.label as mll
from finlab.backtest import sim
from lightgbm import LGBMRegressor

finlab.login()  # finlab 會在需要資料時自動引導登入

# 步驟一:組多因子特徵矩陣(技術面 + 基本面 + 籌碼面),月頻
features = {
    "rsi": data.indicator("RSI"),
    "mom": data.indicator("MOM", timeperiod=120),
    "adx": data.indicator("ADX"),
    "price_pos": data.get("price:收盤價") / data.get("price:收盤價").rolling(240).mean(),
    "pb": data.get("price_earning_ratio:股價淨值比"),
    "rev_yoy": data.get("monthly_revenue:去年同月增減(%)"),
}
X = mlf.combine(features, resample="ME")

# 步驟二:標籤 = 次月相對中位數的超額報酬(排序訊號,而非價位預測)
y = mll.excess_over_median(X.index, resample="ME")

# 步驟三:只用 2018 年底以前的資料訓練模型
dt = X.index.get_level_values("datetime")
train = dt <= "2018-12-31"
model = LGBMRegressor(n_estimators=400, num_leaves=31, learning_rate=0.05)
model.fit(X[train].fillna(0), y[train])

# 步驟四:對全市場打分,每月做多分數最高的前 30 名
score = model.predict(X.fillna(0))
score = pd.Series(score, index=X.index).unstack("instrument")
position = score.rank(axis=1, ascending=False) <= 30

# 步驟五:回測,內扣手續費與證交稅
report = sim(position, resample="M", fee_ratio=0.001425, tax_ratio=0.003)
report.display()整個流程沒有一個地方在預測價位。模型輸出的是一個排序分數,交易訊號來自「分數排在前面」這個相對位置。這正是早年用深度學習模型解析 K 線、標註轉折點的研究想表達、卻沒有用樣本外回測與對帳單證明的論點,本文把它補上。
樣本外驗證:訊號分組是否單調有效
一個排序訊號好不好,最直接的檢驗是把它分成十組,看「模型越看好的組,未來報酬是不是越高」。下圖是 2019 至 2026 樣本外的結果:橫軸是模型分數由低到高分成 10 組,縱軸是各組「次月相對中位數的超額報酬」月平均。
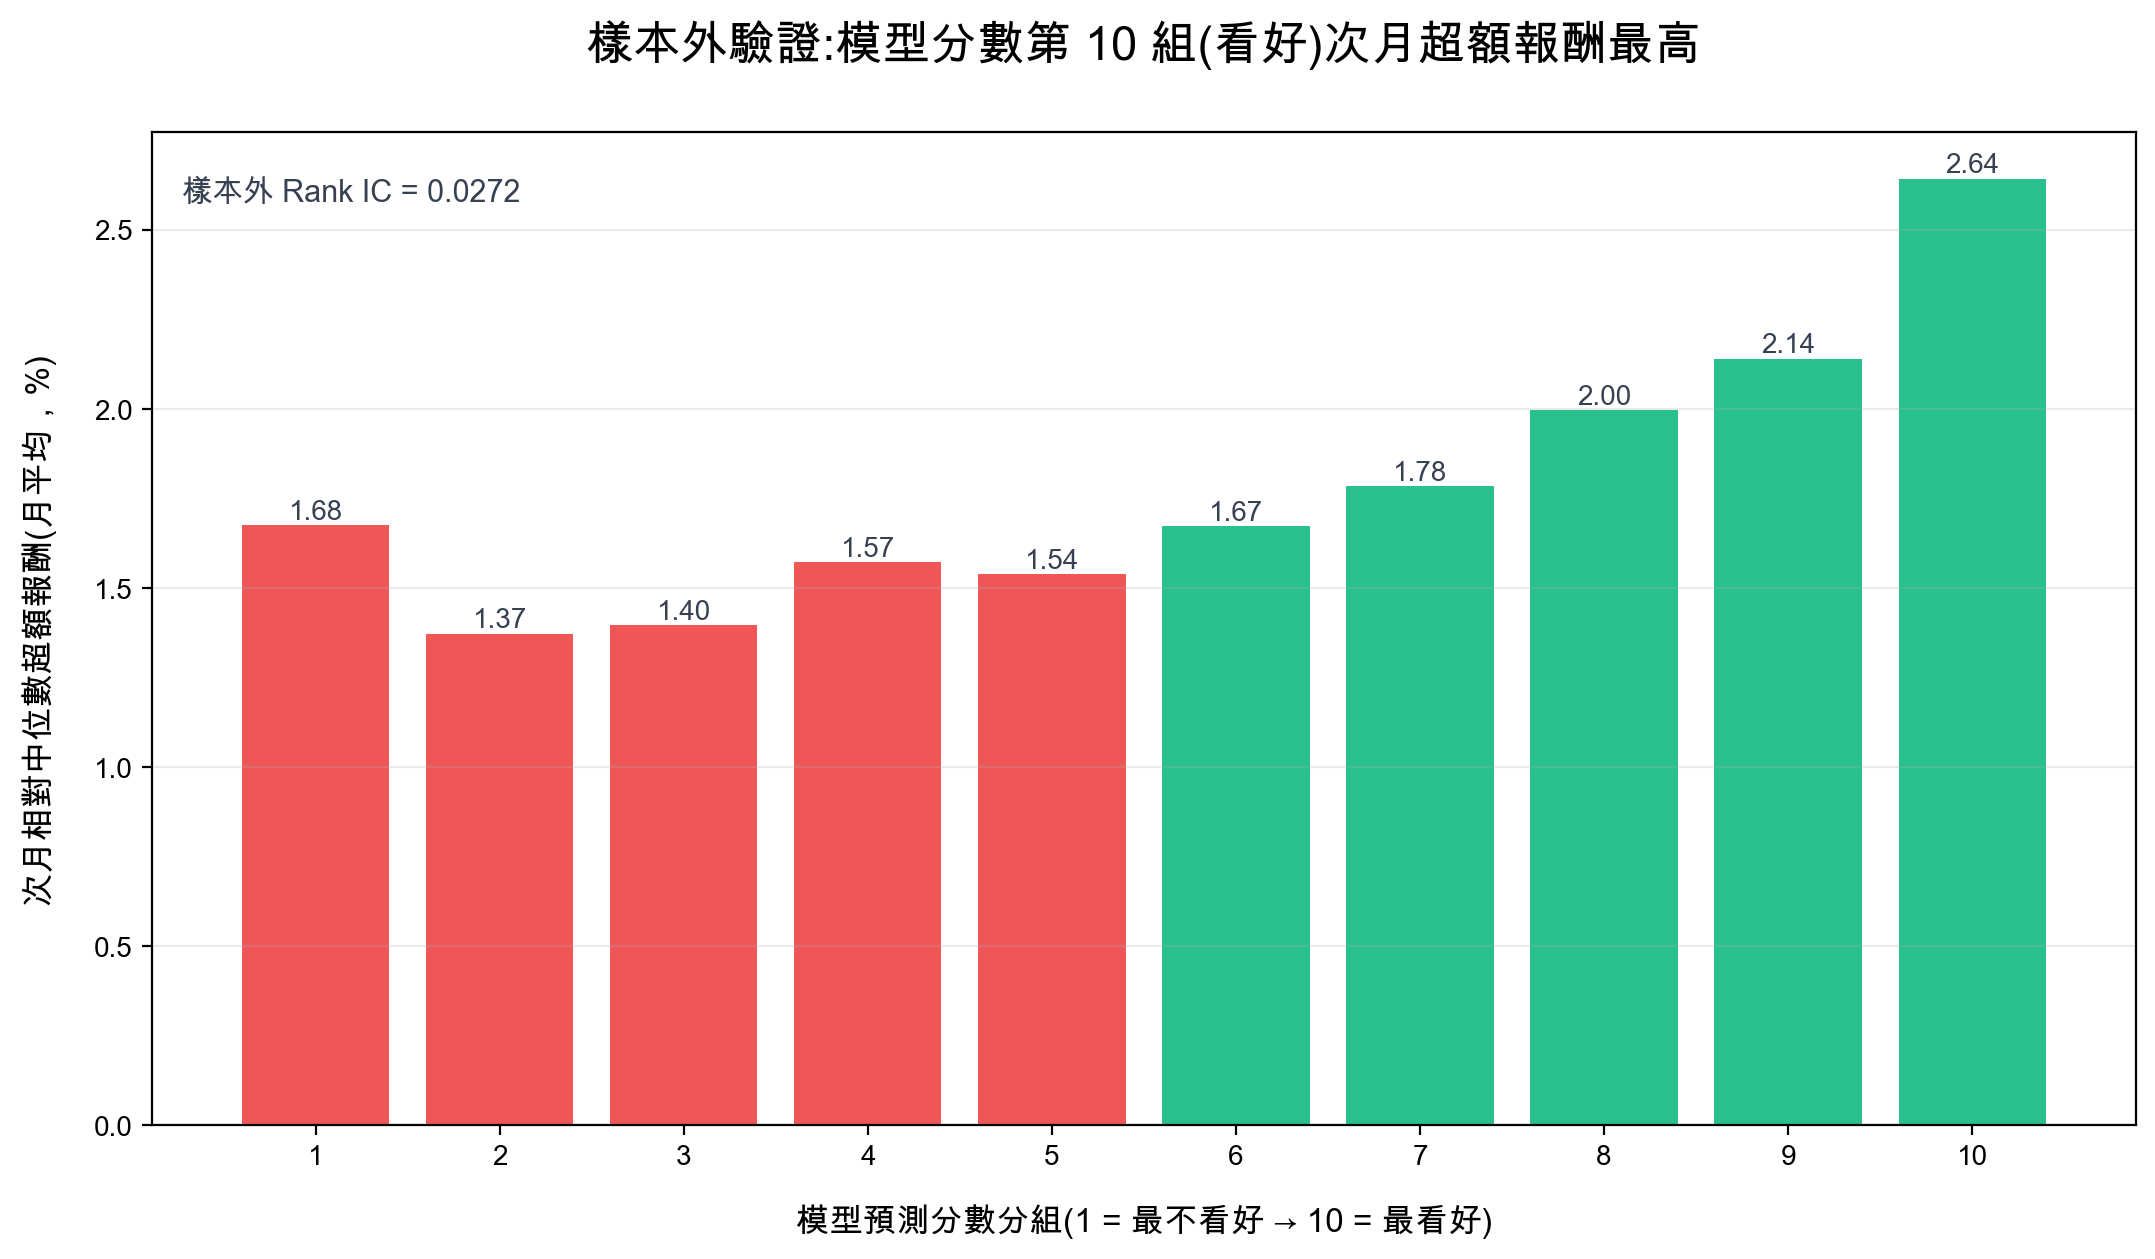
第 1 組(最不看好)月超額 1.68%,第 10 組(最看好)2.64%,由低到高大致單調遞增,第 6 組之後明顯墊高。整體樣本外 Rank IC 為 0.027。這張圖取代了舊版文章那種「事後挑一段漂亮走勢、畫上轉折點」的示意圖:這裡的每一個數字都來自模型在訓練時完全沒看過的期間,沒有事後諸葛的空間。
需要說明的是,這十組的超額報酬全都是正的(1.4% 到 2.6%)。原因是流動性宇宙裡的中型股,在這段期間整體就比全市場中位數強;訊號的價值在於組與組之間的「斜率」,也就是它能把相對更強的標的排到前面,而不在於某一組是正是負。
不是靠某一次切分的運氣:CPCV 15 折檢驗
只跑一次「訓練 2018 以前、測試 2019 以後」的切分,可能只是運氣好。為了排除這點,本文採用 López de Prado (2018) 提出的 CPCV(Combinatorial Purged Cross-Validation,組合式淨化交叉驗證):把樣本切成 6 段、每次抽 2 段當測試集,並在訓練與測試的邊界加上淨化(purge)缺口,避免標籤跨期偷看未來。6 段抽 2 段共有 15 種組合,等於 15 個獨立的樣本外切分。
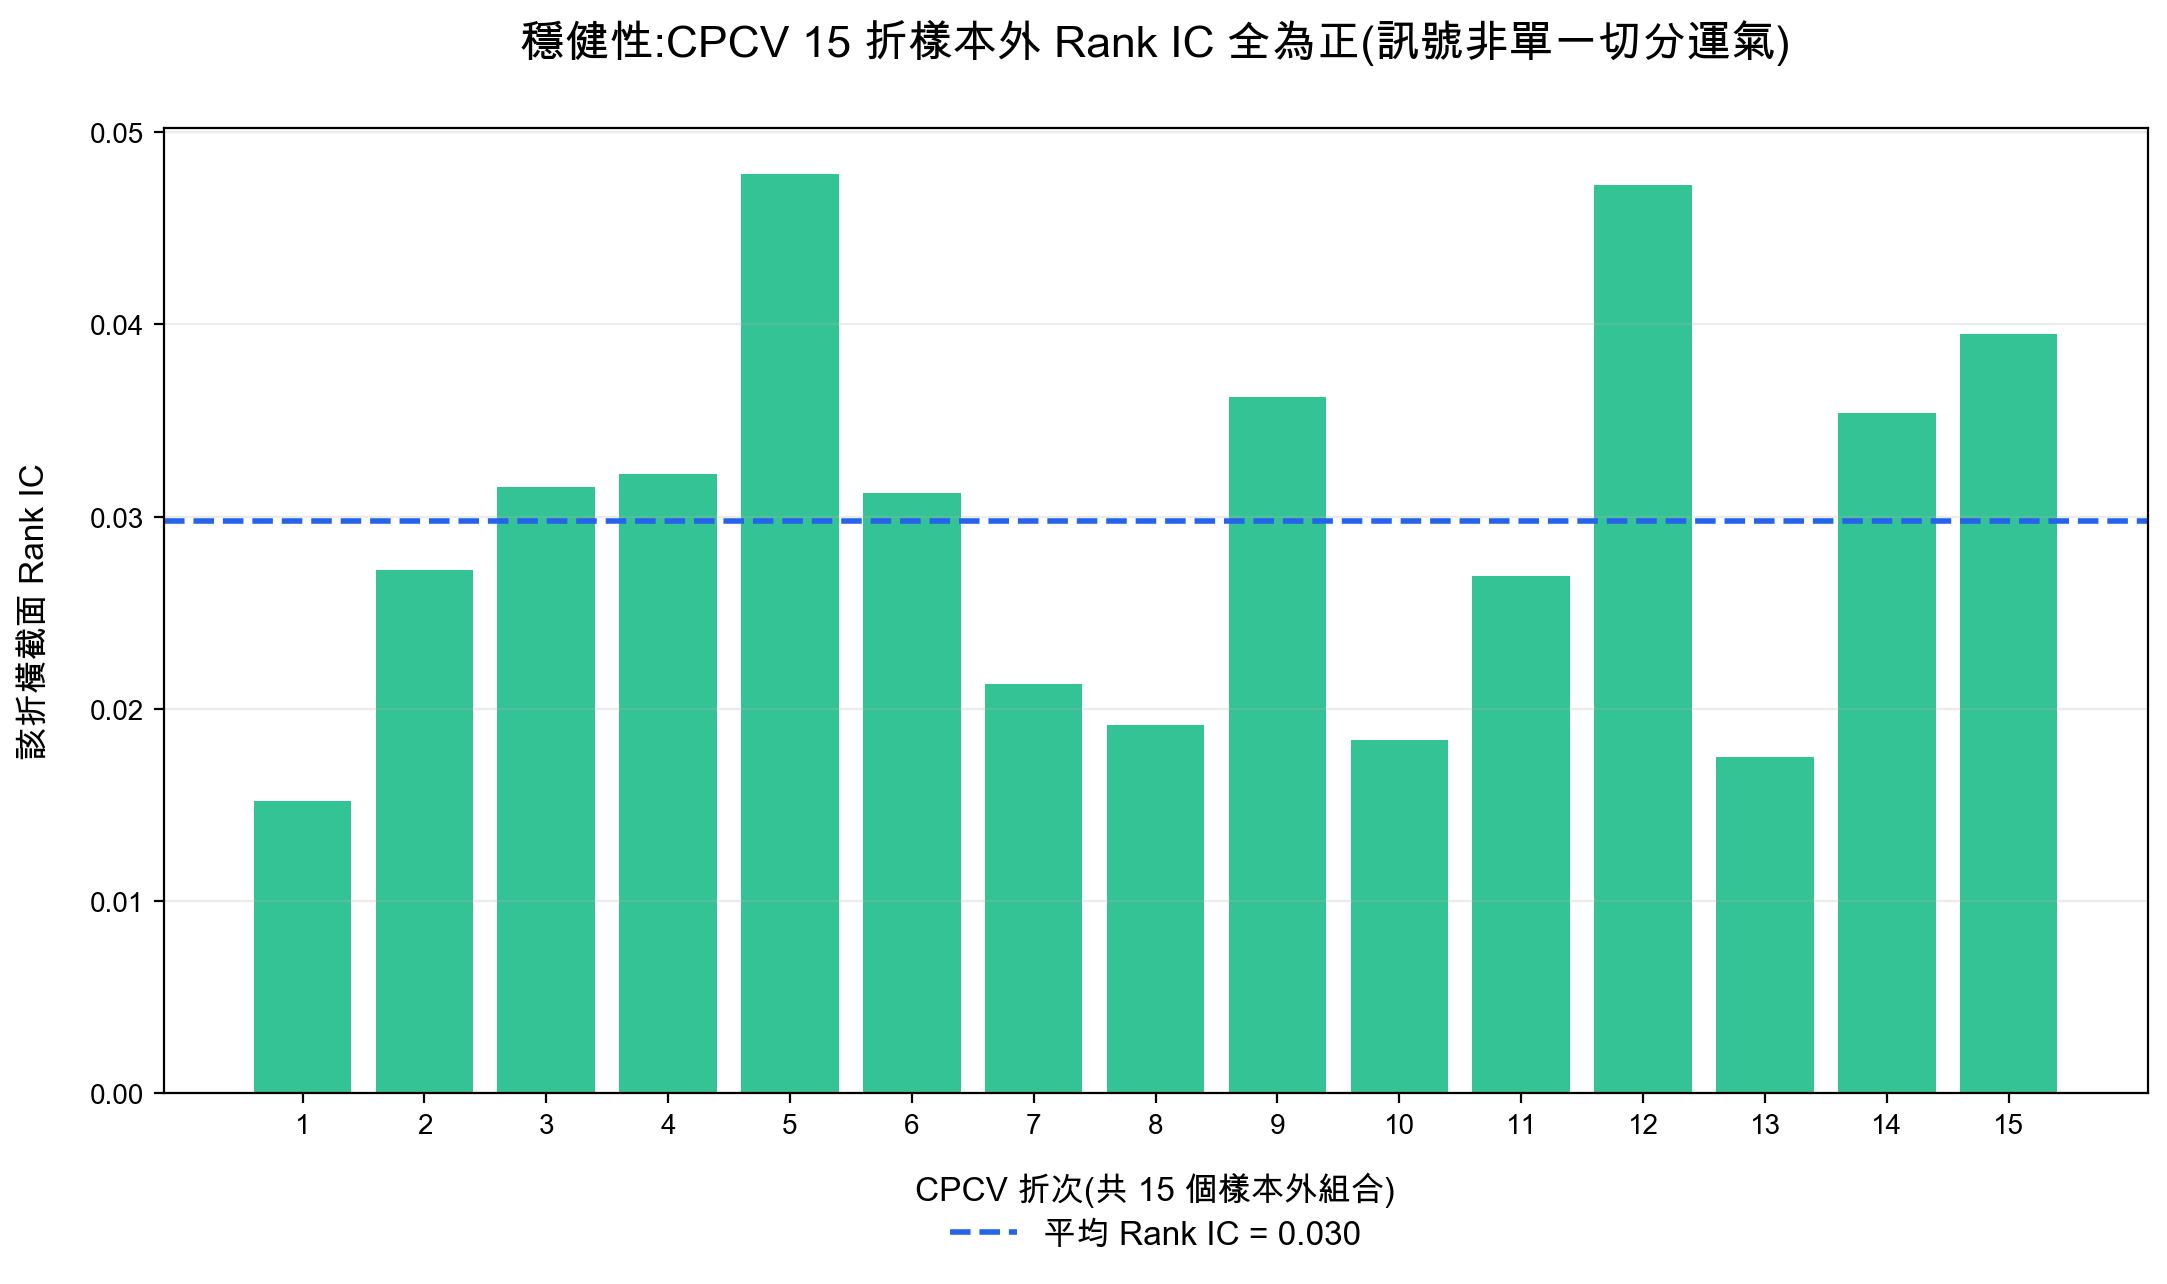
15 折的 Rank IC 全部為正,落在 0.015 到 0.048 之間,平均 0.030。沒有任何一折出現負值。這代表「模型分數能正向排序次月報酬」這件事,並非單一切分的偶然。
訊號有效,為什麼策略還是輸 0050
這是本文最重要、也最容易被略過的一段。訊號的橫截面排序力(Rank IC 為正)與「把訊號做成策略後能否打敗大盤」是兩個不同層次的問題。 把上面那個排序訊號做成「每月買前 30 名」的實際策略,樣本外的成績是這樣:
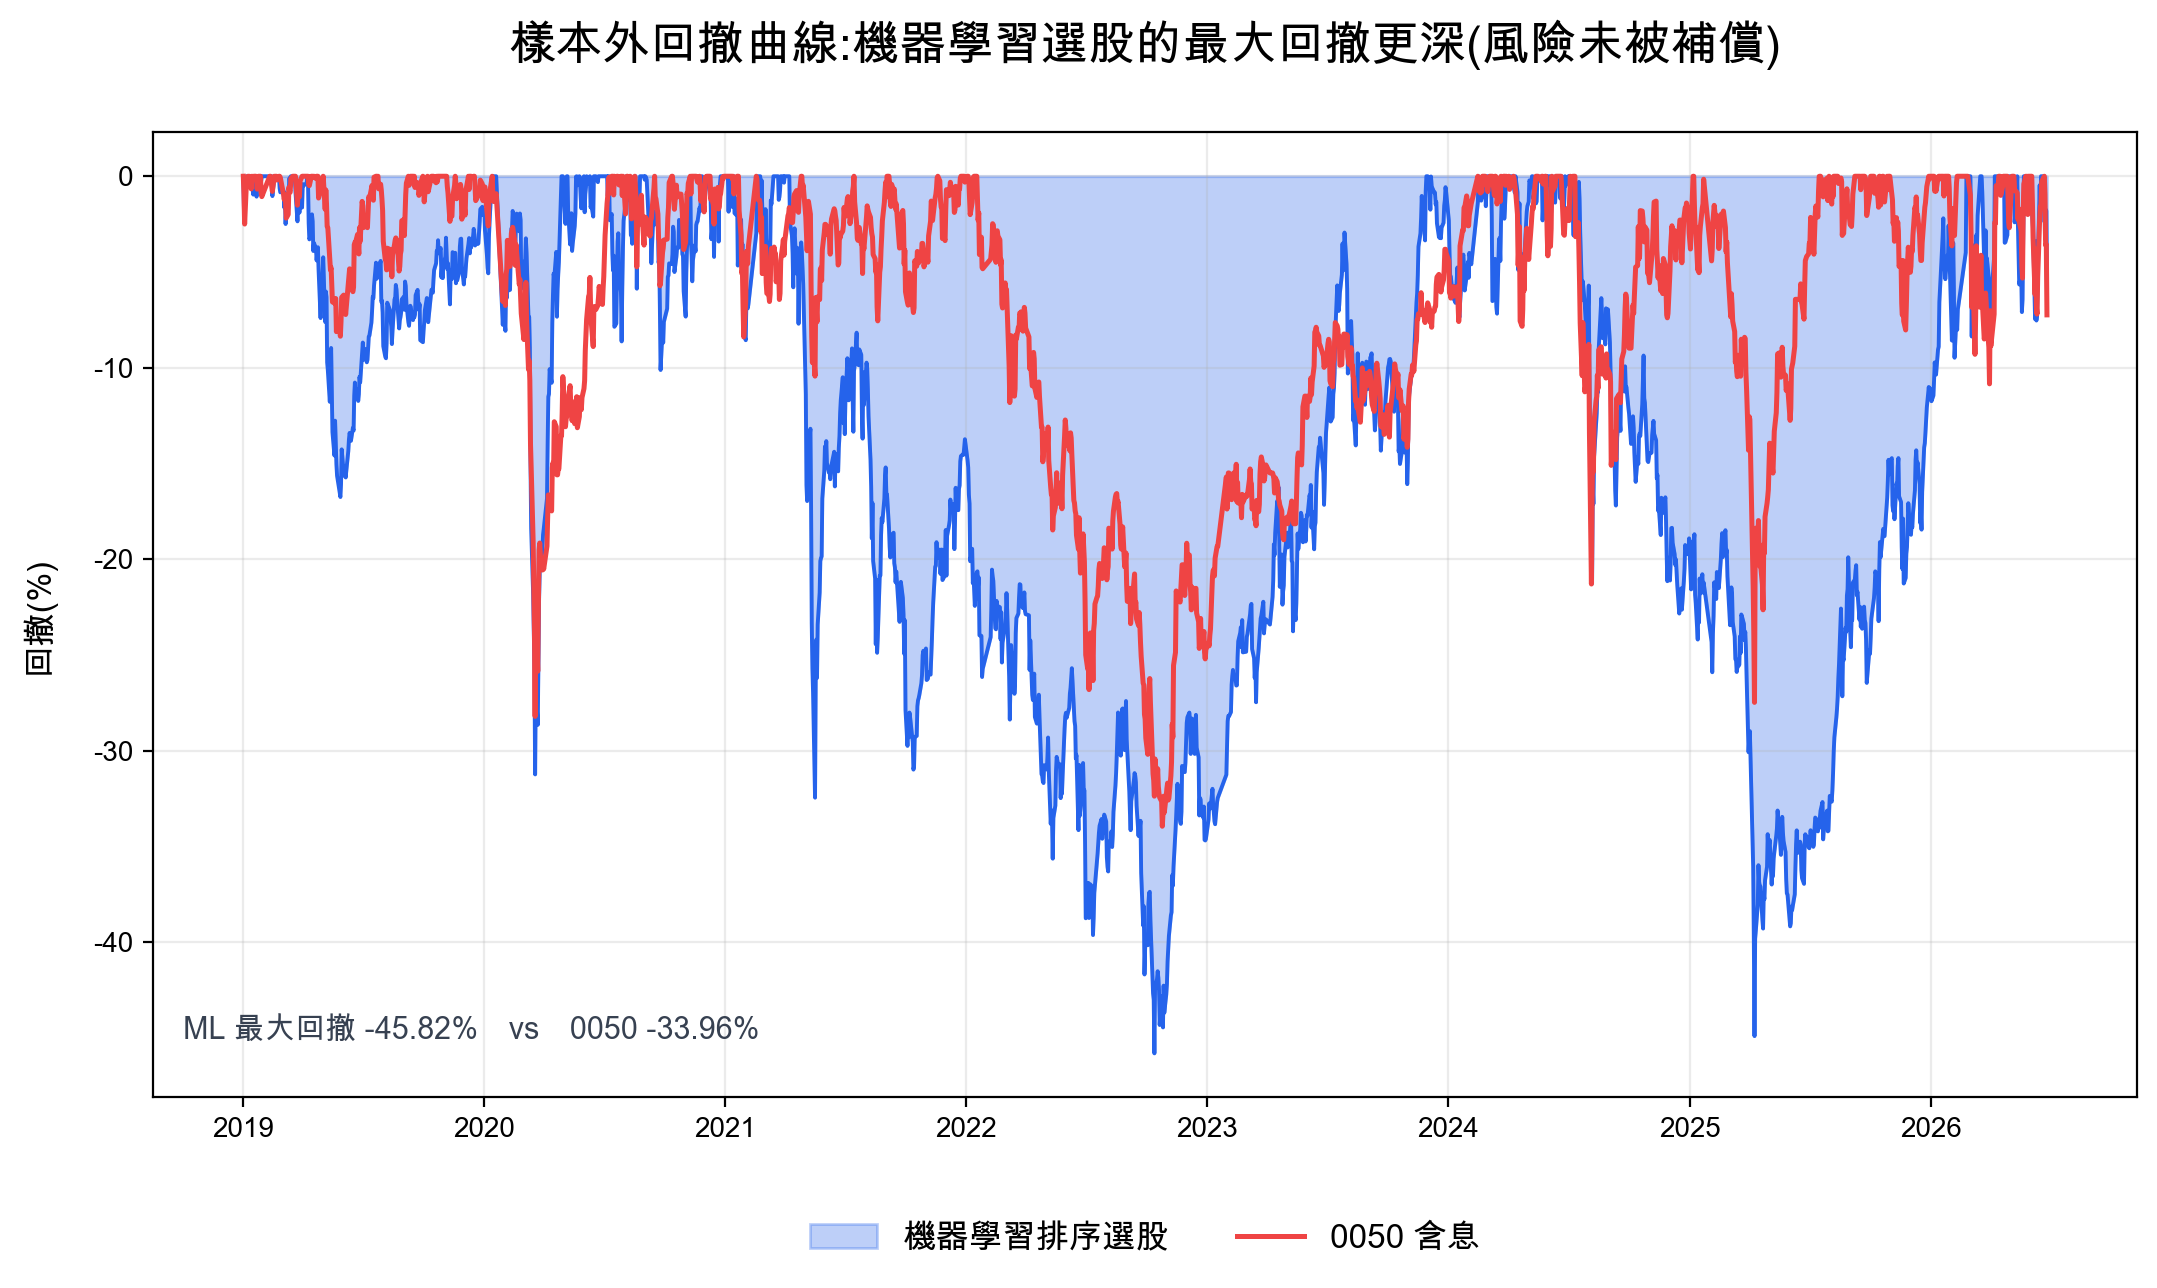
樣本外年化報酬 26.0%,輸給含息 0050 的 29.9%;最大回撤 -45.8%,比 0050 的 -34.0% 還深超過 10 個百分點。也就是說,承擔了更高的風險,換到的卻是更低的報酬,日夏普 0.98 對 1.38,風險調整後完全落後。原因有三個,都很實在。
第一,平均每月周轉率 164%,意思是每個月幾乎整批換股。即使每筆已內扣手續費與證交稅,高頻換股仍會持續啃食報酬,這是排序型訊號天生的弱點。
第二,2019 至 2026 這段期間,台股大型權值股(台積電為首)特別強,而含息 0050 高度集中在這些權值股。一個分散到 30 檔中型股的策略,先天就難贏過押注在少數超級強勢股的指數。
第三,訊號的 Rank IC 雖然穩定為正,但 0.027 的量級偏小。它足以讓「分組單調」這件事成立,卻不足以在扣掉成本與承擔額外波動後,轉化成超越大盤的淨績效。
下面是這個策略的完整互動式回測報告,你可以自行檢視每月持股、年度報酬與回撤明細:
過度配適的代價:樣本內亮眼、樣本外現形
如果只看樣本內,這個模型會讓人誤以為找到聖杯。下圖把樣本內與樣本外的同口徑指標並排(縱軸為對稱對數軸,因為兩者量級差距極大)。
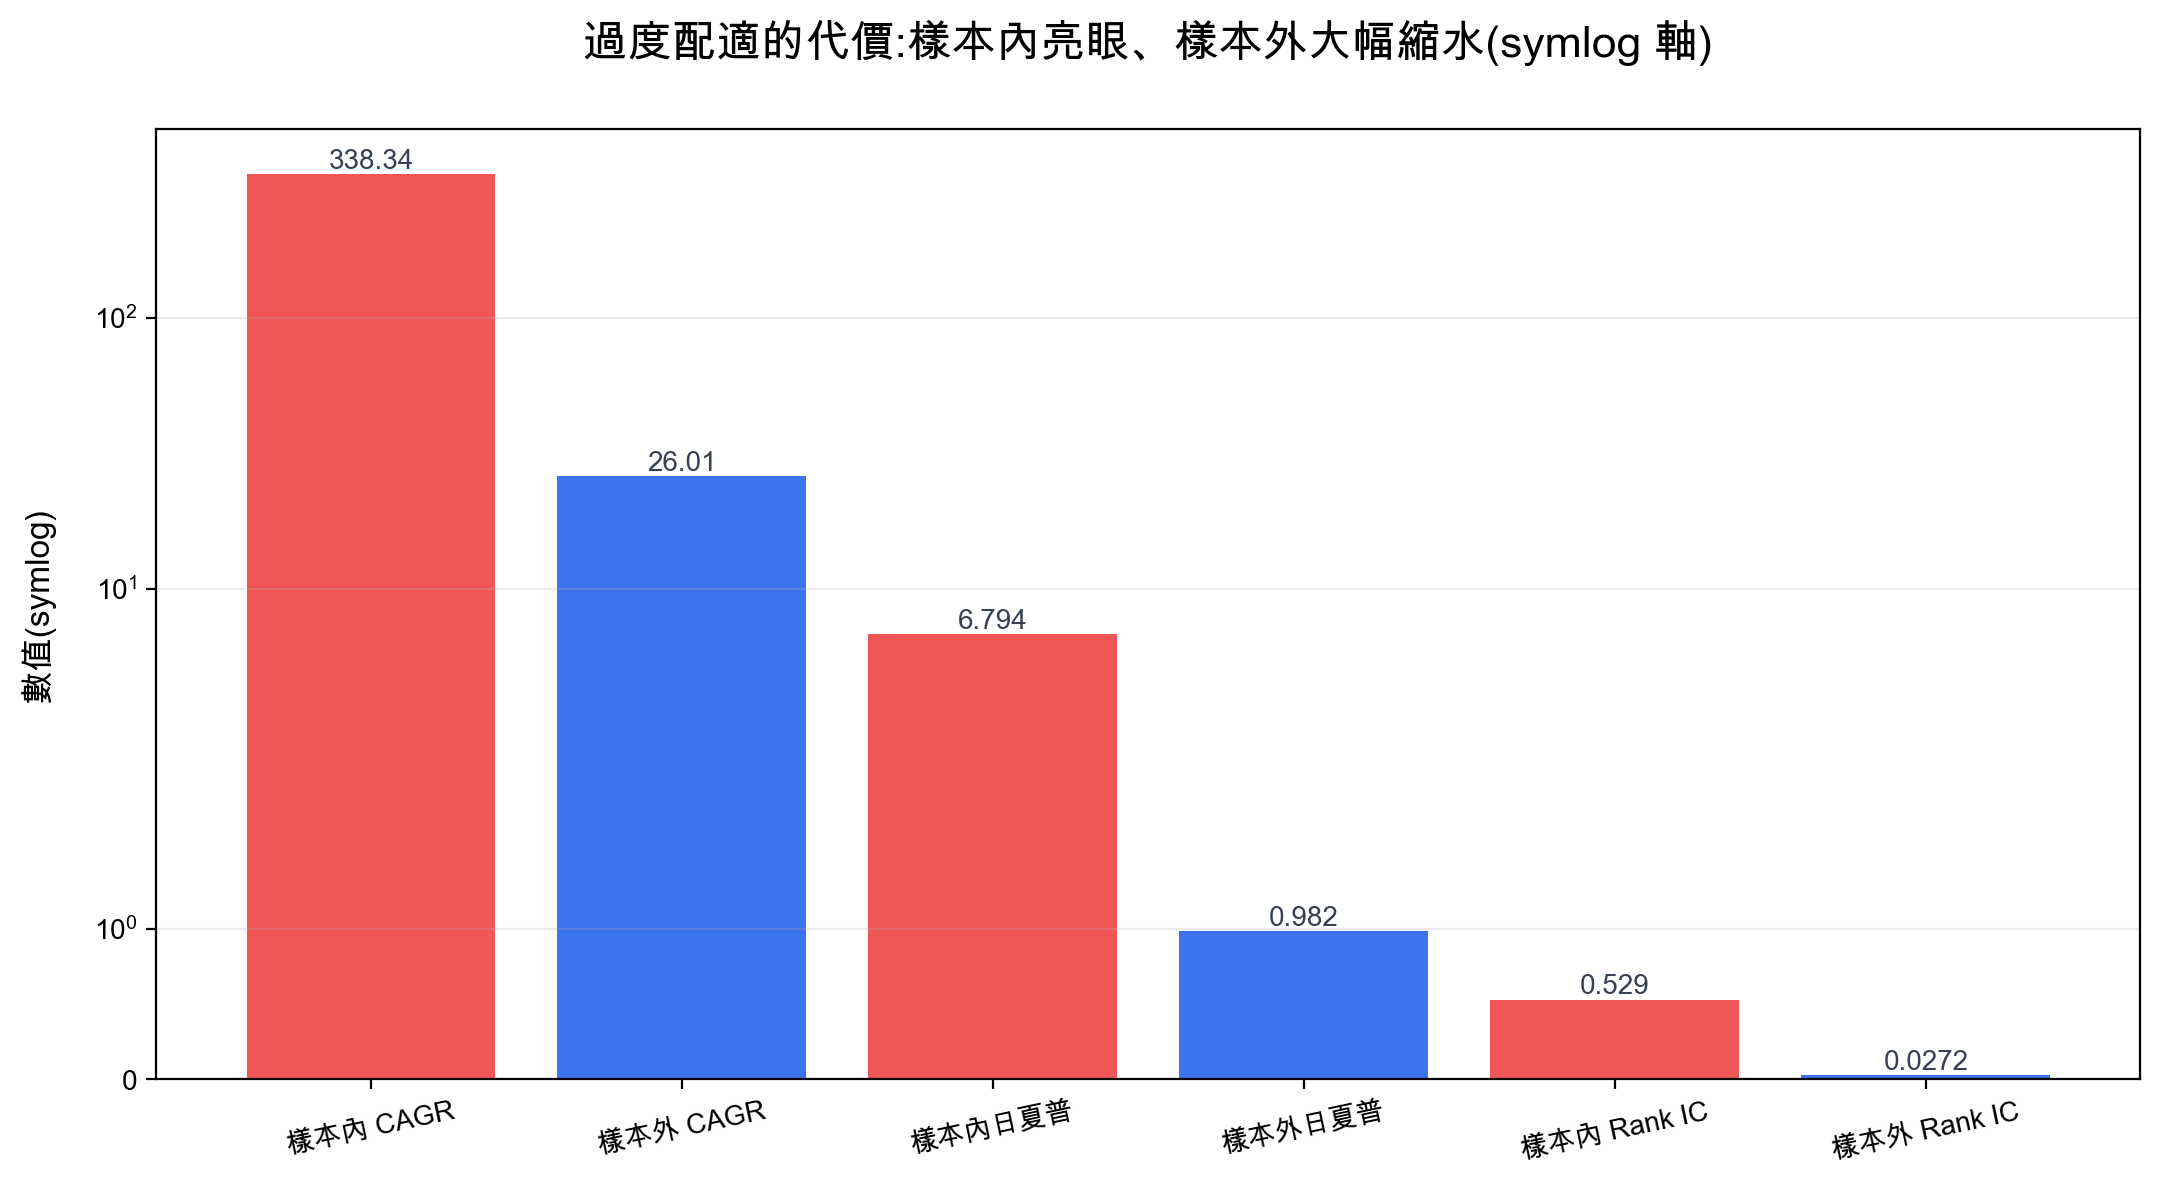
樣本內 Rank IC 0.529、年化 338%、日夏普 6.79,數字漂亮到不真實,因為模型在訓練時已經透過標籤「看過」那段期間的答案。一進到樣本外,Rank IC 掉到 0.027、年化 26.0%、日夏普 0.98。這個落差就是過度配適的代價,也是為什麼任何宣稱機器學習選股年化三位數的成績,只要沒有嚴格的樣本外切分,都應該直接打上問號。關於如何量化一個策略過擬合的機率,可參考用回測過擬合機率判斷策略真實力。
模型究竟在看什麼?下圖是 LightGBM 的特徵重要度。
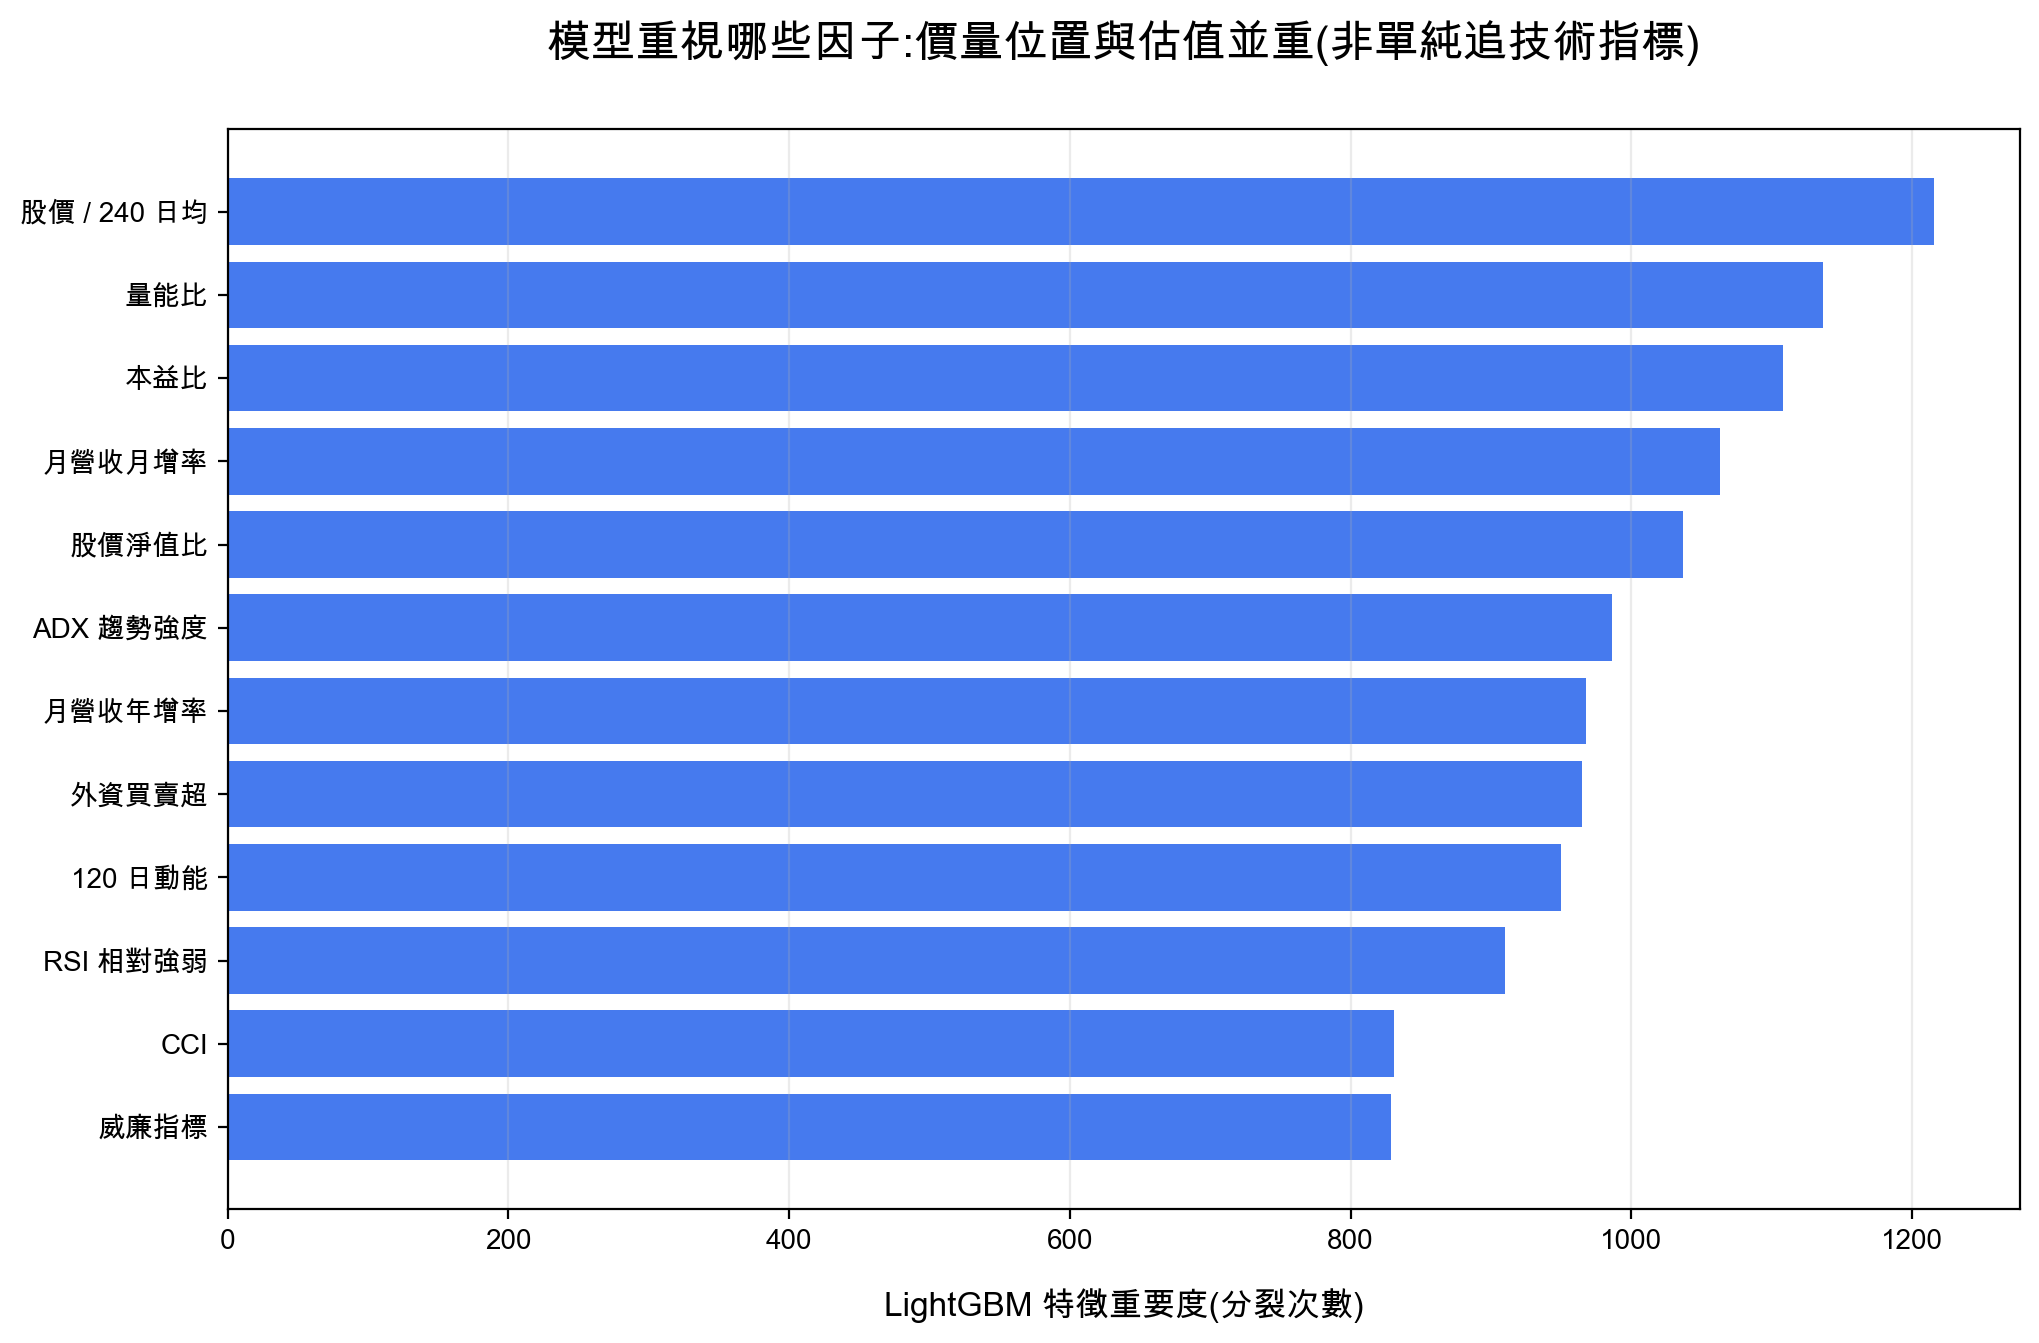
排在前面的是「股價相對 240 日均線的位置」「量能比」「本益比」「月營收月增率」,技術面的價量位置與基本面的估值並重,而非單純追逐某一個技術指標。這也呼應一個常見誤解:把一堆技術指標丟給模型,它不會自動變強;真正有貢獻的,往往是把價量、估值、營收動能、籌碼放在一起的橫截面比較。想知道單一技術指標各自當選股因子的真回測表現,可參考13 個常用技術指標總覽,裡面把 RSI、MACD、均線、ATR 等指標一一拆成因子與風控做了台股長期實測;本文等於把這些指標放進同一個模型,讓它自己學習彼此的相對權重。
機器學習選股的三個過度配適陷阱,以及這份研究怎麼防
網路上多數「AI 預測股價」「機器學習選股年化破百」的內容,問題不在演算法,而在三個反覆出現、卻很少被攤開的過度配適陷阱。這份研究的設計,主要就是針對這三點做防護,把它寫清楚比給一個漂亮數字更有意義。
第一個陷阱是時間洩漏(look-ahead leakage)。最常見的形式,是用一段期間的全部資料訓練、又在同一段期間回測,模型早就透過標籤「看過」答案。本文的樣本內成績正是這個樣子:Rank IC 0.529、年化 338%、日夏普 6.79,數字漂亮到不真實。防護方式是嚴格的時間切分加上 CPCV 的淨化缺口:模型只用 2018 年底以前的資料訓練,2019 年起完全是它沒看過的期間;CPCV 在訓練與測試的邊界再加 31 天淨化缺口,避免次月報酬這種跨期標籤偷看到測試集的未來。一旦把洩漏堵掉,Rank IC 立刻從 0.529 掉到 0.027,這個落差就是洩漏被擠出去後的真實樣貌。
第二個陷阱是只跑一次切分就宣稱有效。單一次「訓練前段、測試後段」的好成績,可能只是剛好那一刀切在對的位置。本文用 CPCV 把樣本切成 6 段、每次抽 2 段當測試集,6 段抽 2 段共 15 種組合,等於 15 條獨立的樣本外路徑。15 折的 Rank IC 全部為正、落在 0.015 到 0.048,沒有任何一折翻負,這才讓「訊號存在」這個結論不依賴某一次幸運的切分。
第三個陷阱是忽略成本與周轉,用無摩擦的紙上績效誇大結論。一個每月幾乎整批換股、平均月周轉率 164% 的策略,若不扣手續費與證交稅,淨值曲線會比實際好看一大截。本文的回測由 finlab sim() 內扣手續費 0.1425% 與證交稅 0.3%,因此呈現出來的樣本外年化 26.0%、日夏普 0.98,是扣掉成本後的數字。也正是把成本算進去之後,這個訊號雖然 Rank IC 穩定為正,卻沒能在扣成本與承擔更深回撤後贏過含息 0050。更多回測與實單之間的落差,可參考回測限制與回測陷阱:過度擬合、流動性與實務落差。
把這三點對照來看就會發現:舊版那種「事後挑一段漂亮走勢、畫上轉折點、宣稱抓到頂底」的示意圖,恰好同時踩中第一與第二個陷阱(用看過的資料、只展示一段),又完全沒回答第三點(沒有對帳單、沒有成本)。本文用真實樣本外回測把這三件事補上,結論即使不漂亮,也是可以被你自己重跑驗證的。我們也把機器學習選股的模擬對帳單每天公開,讓績效在時間裡接受檢驗,而不是只截一張漂亮的圖。
回測方法與口徑限制
把這些數字怎麼算出來的講清楚,比給一個漂亮數字更重要。
- 交易成本: finlab
sim()預設並由本文明確指定內扣手續費 0.1425%、證交稅(賣出)0.3%。 - 滑價: 未額外假設滑價;實際衝擊取決於資金規模與個股成交量,本文未估算策略容量。
- 股票池: 全上市櫃,並以 60 日平均成交額大於 5,000 萬作為流動性過濾,排除代號 00 開頭的 ETF。未特別排除金融股與 KY 股。
- 前視偏差: 特徵均為月底可得資料;月營收用 finlab 對齊後的公布期數,價量與估值用月底收盤計算;標籤用次月報酬,並在 CPCV 訓練與測試邊界加 31 天淨化缺口。
- 權重: 等權,單檔上限設 10%。
- 周轉率: 平均每月約 164%,屬高周轉,成本敏感。
- 樣本內外: 模型只用 2018 年底前資料訓練,2019 年起為樣本外;另以 CPCV 15 折交叉驗證穩健性。
把可重現的程式碼與資料一起附上,是為了讓你能自己驗證、甚至推翻本文的結論。讀到這裡想自己動手,用一句話讓 AI 幫你把 finlab 環境設好,再用真實台股資料跑一次這個排序訊號的回測:
適合誰、不適合誰
這套方法適合:想理解「機器學習在量化選股裡的正確定位」、願意接受訊號有效但不保證打敗大盤、並且想用真實樣本外回測檢驗每一個宣稱的人。它不適合:想找一鍵賺錢黑盒、或只看樣本內漂亮數字就下重注的人。本文的結果其實是個好消息:它示範了一套可重現、把成本與限制都攤開的研究流程,能讓你在投入真金白銀前,就分辨出「訊號有沒有用」與「策略能不能賺」這兩個不同的問題。
常見問題
機器學習真的完全無法預測股價嗎? 預測「精確價位」在實務上幾乎注定失真,因為股價非穩定序列、且低誤差不等於可獲利。但預測「橫截面相對排序」是可行的:本文樣本外 Rank IC 為正、分組單調,就是證據。
為什麼標籤要用次月超額報酬,而非原始報酬率? 因為相對中位數的超額報酬把「整體大盤漲跌」這個共同因子扣掉了,模型專注學習「誰相對更強」,這正是選股要的。若改以絕對報酬當標籤,模型會被多空頭的市場 beta 主導。
這個策略現在能照單買進嗎? 不建議。它在樣本外輸給含息 0050、且回撤更深。本文的價值在於方法示範與訊號驗證,並非提供一份可照抄的下單清單。
Rank IC 只有 0.027 會不會太低? 單因子或單模型月頻 Rank IC 約 0.03 到 0.05 就算可用。0.027 偏低但穩定為正,足以證明訊號存在,卻不足以在扣成本後贏過大盤。延伸閱讀:Rank IC 是什麼,和 Pearson IC 差在哪。
怎麼把這個訊號改善成能打敗大盤? 方向包括降低周轉(拉長持有期、加入換股緩衝)、疊加品質與低波因子降低回撤、或把訊號當成擇股輔助而非全部。可參考多因子選股策略:營收+動能+ROE+低波。
CPCV 跟普通交叉驗證差在哪? 普通交叉驗證會讓相鄰時間的樣本互相洩漏未來資訊。CPCV 在訓練與測試邊界加淨化缺口,並用多種組合取得多條樣本外路徑,對時間序列更嚴謹。
延伸閱讀
- Machine Learning 選股新手教學:用隨機森林實作量化選股
- 用 Python 預測股價:Facebook Prophet 預言家模型實戰教學
- 台股怎麼選股?四大面向完整指南
- RSI 指標台股 11 年回測:當動能選股因子的純技術策略
- Rank IC 是什麼?和 Pearson IC 差在哪
- Information Coefficient(IC)是什麼?台股因子實測
- 多因子選股策略教學:營收+動能+ROE+低波
- 回測過擬合機率(PBO)怎麼算
- 回測限制與回測陷阱:過度擬合、流動性與實務落差
- 用 AI 提示詞跑台股回測:可重現的選股對帳單
- 量化交易完整指南
- 量化名詞詞彙表:夏普比率定義
參考文獻
- Gu, Kelly & Xiu (2020), Empirical Asset Pricing via Machine Learning:大型實證指出機器學習對報酬的價值主要來自橫截面排序,而非單一資產的價位點預測,直接支持本文「用排序訊號取代價位預測」的設計。
- Jegadeesh & Titman (1993), Returns to Buying Winners and Selling Losers:動能效應的經典證據,支持以相對強弱(橫截面排序)作為選股訊號的合理性,也解釋為何本文的價量位置特徵重要度偏高。
- López de Prado (2018), Advances in Financial Machine Learning:提出 CPCV 與淨化交叉驗證,用於避免時間序列回測的資訊洩漏與過度配適,是本文 15 折穩健性檢驗的方法依據。
下載與重現
投資警語:本文為機器學習量化選股的方法教學與回測說明,所有數據與範例僅供研究參考,不構成投資建議。過去績效不代表未來表現,本文策略在樣本外輸給含息 0050,投資前請自行評估風險。
最後更新:2026-06|回測區間:2019-01 至 2026-06 樣本外(訓練資料 2010 至 2018)|作者:FinLab 量化研究團隊(經量化研究員審閱)
FinLab AI
想建立自己的策略?
用自然語言描述你的選股想法,AI 自動驗證、回測、給你答案
免費開始